Quelques textes un peu trop longs pour mastodon (garanti 0% de matière IAsse)

Florence Maraninchi

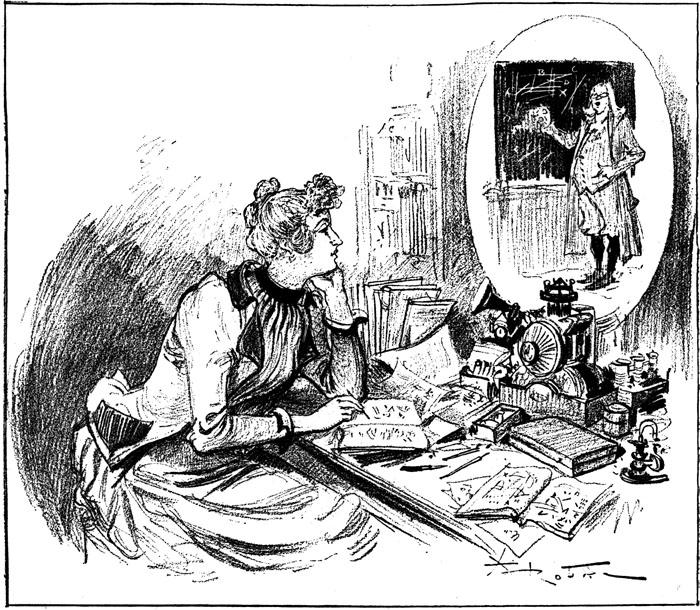
Une dame habillée à l'ancienne devant un écran où apparaît un professeur habillé à l'ancienne aussi

LES COURS PAR TÉLÉPHONOSCOPE. Albert Robida, “La vie électrique”, 1892

TL;DR : Quelques réflexions sur un des effets néfastes (parmi tant d'autres) des IAg dans l'enseignement : plus rien n'est perçu comme infaisable par les étudiants, on a perdu un capteur essentiel au fonctionnement en boucle fermée de l'enseignement (et pas seulement synchrone).


L'enseignement synchrone, avec des enseignants et des étudiants présents au même endroit en même temps et en chair et en os, ça fonctionne par boucles de rétroaction. Si vous avez lâché tout le monde en allant trop vite, en étant confus, en partant dans des digressions hors plan, etc., vous le voyez dans les yeux des gens en face de vous, dans l'attitude globale de l'amphi, vous l'entendez dans le niveau de brouhaha qui monte. Grâce à ces capteurs dans le public vous pouvez adapter la vitesse et le discours, remettre le plan pour bien situer où on en est et ce qu'on est en train de faire, etc.

Ce dont on se rend moins compte, c'est que c'est aussi comme ça que marche l'asynchrone, simplement avec des temps de réaction plus longs. Si vous demandez une synthèse de votre cours en une page, pour forcer les étudiants à extraire les quelques points principaux et leur articulation, c'est à la fois pour leur faire faire l'exercice, et pour mesurer à quel point les quelques points importants que vous aviez en tête sont bien ceux qui ressortent après transmission aux étudiants. Si un cours passe mal et que vous avez 5 étudiants, ça ne donne pas beaucoup d'information. Mais s'il y en a 100 et qu'ils sont tous passés à côté des notions que vous vouliez absolument transmettre, il faut bien se rendre à l'évidence : c'est de votre côté que quelque chose ne marche pas. Ce n'est en général pas agréable, il faut bien le reconnaître, mais enfin, si à 50 ans tu n'as pas complètement raté un cours au moins une fois, c'est que n'es pas enseignant. 100 étudiants qui discutent entre eux et constatent que personne n'arrive à ressortir les notions importantes, ça donne un très bon capteur de qualité du cours, et surtout ça leur donne l'assurance de venir rouspéter en disant que c'était impossible de faire bien le travail demandé.

Vous me voyez venir, j'imagine. Ce que je décris là pour la partie asynchrone, c'était avant les IA génératives. Maintenant on ne peut plus demander des travaux de synthèse en asynchrone, à faire “à la maison” (expression que j'ai toujours trouvée bizarre, vu que la plupart du temps c'est : à faire dans vos 9 m^2 de chambre d'étudiant, mais ne nous égarons pas). J'ai déjà parlé ici de plusieurs raisons : – Il y a de fortes chances que notre cours (pourtant en licence CC-BY-NC-SA) soit tout simplement donné à un vendeur d'IAg, qui plus est enrichi de questions et raffinements demandés par l'étudiant consciencieux. C'est du pillage, personnellement ça ne me réjouit pas du tout. – On devra passer du temps, payés par de l'argent public, à lire des textes générés par des IAg totalement opaques. C'est un mauvais usage de l'argent public et ça participe de la banalisation de ces “outils” qui enrichissent des personnes tout à fait politiquement infréquentables, dégradent l'environnement qui n'a déjà pas besoin de ça pour aller mal, pillent et privatisent les communs de la connaissance, etc. Cf. Pourquoi je n'utilise pas ChatGPT et notre lettre ouverte aux scientifiques qui consomment de l'intelligence artificielle générative.

Mais surtout : on a cassé le thermomètre ! Plus personne ne viendra vous dire que ce que vous demandez est infaisable avec le contenu du cours. Parce que plus rien n'est perçu comme infaisable, et que les étudiants ne discutent plus entre eux quand ils rencontrent une difficulté. Une IAg fournira toujours quelque chose, et vu la quantité de textes digérés par ces machins, à moins d'avoir fait un cours sur une notion toute neuve et particulièrement exotique, il y a évidemment des quantités considérables de textes parlant des sujets du cours, quelque part sur le web et donc dans les entrailles des outils d'IAg. Si de notre côté nous ne mettons pas le holà à ces pratiques, si nous considérons que “c'est déjà là”, “il faut s'adapter”, “il faut accompagner les étudiants”, … alors nous disparaîtrons. Si la boucle d'interaction avec une machine semble fonctionner, qui plus est à grande vitesse, alors que la boucle formée par un enseignant et un groupe d'étudiants en chair et en os ne marche plus par manque de thermomètre, et ne peut de toute façon pas rivaliser en vitesse, alors nous disparaîtrons. C'est malheureux pour nous, bien sûr, mais encore plus pour les étudiants qu'on aura livrés pieds et poings liés à des entreprises privées opaques appartenant à des individus aux objectifs discutables. Il n'y a pas de compromis possible. On résiste, ou on se jette dedans. Rien ne sert de freiner dans les chutes du Niagara. Voir l'excellent texte de Christine Lemmer-Webber sur la notion de “vibe bobsled”.
#resistIAGen

@flomaraninchi@pouet.chapril.org

Dans quel cadre utilisez-vous HAL-MCP ?

Je ne l'utilise pas et j'aimerais être sûre que l'interface normale continuera à exister

Décrivez votre principal cas d’usage de HAL-MCP

Je ne m'en servirai à aucun prix.

Avec quel chatbot utilisez-vous le serveur HAL-MCP ?

Aucun, je n'ai pas envie d'enrichir les techno-fascistes américains pour faire mon travail

Quelles améliorations ou fonctionnalités souhaiteriez-vous voir ajoutées à HAL-MCP ?

Le retirer complètement. J'espère que les maigres moyens disponibles pour des infrastructures comme HAL, déjà victimes du pillage et de DDOS par les robots IA, ne sera pas dépensé sur de telles futilités gaspilleuses de ressources.

Avez-vous d’autres commentaires ou suggestions ?

Votre adaptation est une forme de capitulation. Ce choix est fondamentalement politique, ne pas se poser la question “à quel prix ?” est consternant. Vous avez une interface correcte, c'est la moindre des choses qu'un chercheur ou une chercheuse sache remplir les champs pour trouver ce qu'elle veut, c'est même plus rapide que de faire une phrase alambiquée pour essayer de dire la même chose de manière non ambiguë, en ayant besoin de la démesure des infrastructures LLM pour faire le job. Il y a un risque de biais (on ne sait pas débiaiser un LLM), de fuite d'informations, les résultats seront non-déterministes, ... C'est désespérant de voir la recherche publique et la science ouverte se livrer ainsi à des prédateurs largement pires que les revues prédatrices.

#resistIAGen

@flomaraninchi@pouet.chapril.org

Dans un article – Tokenmaxxing and the failure of simplistic AI metrics – dénonçant la métrique du nombre de tokens consommés comme mesure de la productivité des développeurs (toutes les métriques sont soumises à la loi de Goodhart quand on prétend les transformer en indicateurs de performance, mais celle-ci a le côté absurde de ne même pas prétendre mesurer une sortie du processus de production, mais une entrée de ressources consommées pour la dite production), on trouve cette phrase, présentée comme une approche rationnelle de la question :

“Anthropic’s guide on context engineering formulates it quite clearly: the goal is to find the smallest possible set of high-signal tokens that maximizes the probability of obtaining the desired result.”

Arrêtons-nous quelques instants sur cette phrase.

Il ne s'agit même plus de prétendre programmer en langue naturelle, intention mal orientée et déjà vouée à l'échec comme le disait très bien Dijkstra dans “On ne foolishness of natural language programming”.

Il ne s'agit plus non plus d'utiliser les LLM, qui ont digéré une énorme quantité de code et de texte associé, comme un outil de recherche dans la documentation pléthorique d'une base de code qui a crû au-delà du pratiquement utilisable. Voir Drowning in code: The ever-growing problem of ever-growing codebases.

Non, il ne s'agit plus de programmer une machine, ni de chercher l'information nécessaire à cette activité, mais d'invoquer une entité au comportement incertain et capricieux.

Comment la discipline informatique, partie des lampes à vide et des transistors, de la programmation aux clés et des cartes perforées, pour s'élever lentement du langage binaire au zoo actuel de langages et de paradigmes de programmation, en ayant inventé au passage la compilation, l'interprétation, la compilation à la volée, l'architecture de Von Neuman, la hiérarchie mémoire, la prédiction de branchement et autres astuces du matériel, la programmation dynamique, distribuée, parallèle ou temps réel, et un bon millier d'autres notions étonnamment sophistiquées et élégantes, comment la discipline informatique, disais-je, a-t-elle pu muter en cette secte d'adorateurs de l'IA générative ou agentique, où l'on se transmet dans des clubs fermés les recettes du guidage de la bête vers le résultat attendu ?

Je comprends fort bien l'intérêt d'Anthropic, OpenAI et consorts dans cette affaire. Aussi désespérante que soit la Théorie de l'économie morte, elle est parfaitement compréhensible et convaincante. Aussi étonnant que cela puisse paraître au premier abord, vendre un outil en prétendant ne plus le comprendre est une stratégie parfaitement maîtrisée (voir The Black Box Myth: What the Industry Pretends Not to Know About AI).

Je comprends le dilemme des employés forcés d'utiliser les agents IA pour convaincre leur employeur qu'ils ont à coeur d'augmenter la productivité de leur entreprise.

Mais comment un informaticien ordinaire peut-il se laisser prendre aux sirènes de l'IA agentique ? Ce chant est-il si irresistible qu'il pousse à abdiquer dans l'instant toutes ses compétences de conceptualisation et de construction de logiciels pour se transformer en moinillon débutant dans la religion de l'IA agentique, avec pour seule aspiration de devenir grand prêtre par une étude sans fin des grimoires où sont consignées les invocations de la secte ?

#resistIAGen

@flomaraninchi@pouet.chapril.org

La pétition Pour une Convention citoyenne sur l'Intelligence Artificielle circule pas mal en ce moment. Je ne la signerai pas.

J'aimerais vraiment beaucoup qu'il y ait une convention citoyenne sur le déploiement des IAg à marche forcée, mais la pétition telle qu'elle est me semble aborder la question sous un angle très problématique.

Je pense que le problème n'est vraiment pas le risque d'IA générale, la fameuse “superintelligence”. Et qu'agiter cet épouvantail est un bon moyen de masquer les dégâts bien réels à raz de terre, ici et maintenant. Par exemple la loi de simplification de l'état qui classe les datacenters dans les infrastructures stratégiques (et du coup on ne demande plus l'avis de personne). Data for Good a fait une bonne analyse de cette histoire : https://www.linkedin.com/posts/dataforgood_loi-simplification-de-la-vie-economique-activity-7451879853995397120-IATT

Le déploiement des datacenters en France semble juste incompatible avec la stratégie nationale bas carbone : https://www.lesechos.fr/idees-debats/cercle/explosion-de-lia-la-france-devra-arbitrer-entre-alimenter-ses-data-centers-et-decarboner-ses-transports-et-son-chauffage-2222020

Par ailleurs, faire peur sur l'IA générale et la superintelligence est une stratégie délibérée des vendeurs d'IAg. C'est très bien analysé dans le livre “Les prophètes de l'IA” de Thibaut Prévost, ou dans ses chroniques sur Arrêt sur Images/ Il dit en particulier : “Cette double Apocalypse – l'IA nous sauvera toustes/ l'IA nous détruira toustes – et ses multiples déclinaisons impliquent et entretiennent la même certitude techno-déterministe : celle de l'émergence inévitable de l'IAG, de la même manière que les récits du Paradis et de l'Enfer légitiment chacun l'existence de Dieu. En d'autres termes, tous ces types croient, dur comme fer, à la possibilité et l'imminence d'une machine pensante à la puissance divine.”

Voir aussi un texte d'il y a 3 ans, dû à Emily Bender. Il y avait eu une lettre du FutureOfLife Institute demandant une pause sur l'IA, avec des arguments du même genre que la pétition ci-dessous.

Ursula von der Leyen a eu droit récemment à une lettre de scientifiques du domaine quand elle a fait mine de croire que les machines à faire des phrases allaient atteindre le niveau de l'intelligence humaine : https://www.iccl.ie/wp-content/uploads/2025/11/20251110_Scientists-letter-to-the-President-AI-Hype.pdf

Le phénomène de “hype” est un risque politique en soi : https://www.techpolicy.press/expanding-hype-literacy-to-protect-democracy/ On y lit :

“In a historical context where tech leaders are openly embracing neo-reactionary (and intellectually shallow, ill-informed) positions such as the dark enlightenment and effective accelerationism, assessing hype is critical. Especially when the myth of Artificial General Intelligence (AGI) —a sociotechnical fiction itself, since it has been repeatedly considered unachievable through Large Language Models — has amassed the largest private capital investment round in history. The cocktail of deep pocket actors embracing both unrealistic visions and extreme political positions make hype a strategy to make imagination come true — and therefore an urgent matter of political attention.”

Bref, je pense que propager le discours sur l'avènement de la superintelligence, c'est servir les idées de gens tout à fait politiquement infréquentables (voir les explications sur la mouvance TESCREAL). Alors qu'il y a énormément de choses à dire sur le déploiement à marche forcée partout, mais avec des arguments tout à fait terre à terre. Voir par exemple le collectif “Le nuage était sous nos pieds” ou Stop Dataone.

#resistIAGen

@flomaraninchi@pouet.chapril.org

Image

Wilkins & Co. Factory – 1860s – Chase & Bachrach (American, founded about 1865, dissolved 1868)

Ironies of Automation

En 1983 Lisanne Bainbridge publia dans une revue d'automatique un article intitulé Ironies of Automation, ce que l'on peut traduire par : les contradictions (ironiques) de l'automatisation. Elle y développe l'idée que, plus un processus est automatisé, plus il doit être surveillé par un être humain compétent, alors même que cet humain perd sa compétence du fait de ne plus exercer le travail que réalise maintenant le système automatique. Toute ressemblance avec les promesses d'une certaine technologie à la mode ces temps-ci serait totalement fortuite.

Dans un article de 2012 intitulé The ironies of automation: still going strong at 30?, les auteurs terminent leur résumé par ce constat tout à fait d'actualité : “The more we depend on technology and push it to its limits, the more we need highly-skilled, well-trained, well-practised people to make systems resilient, acting as the last line of defence against the failures that will inevitably occur.” (Plus nous dépendons de la technologie et approchons de ses limites, plus nous avons besoin de personnes douées, bien formées et expérimentées pour faire en sorte que les systèmes soient résilients, comme dernière ligne de défense contre les pannes qui ne peuvent manquer de se produire – je traduis).

Sûreté des systèmes automatisés

En lisant l'article de L. Bainbridge 43 ans plus tard, on ne peut s'empêcher de penser que, pourtant, des processus industriels ont été automatisés complètement, qui plus est grâce au numérique. C'est le domaine des systèmes embarqués critiques, auxquels on pense relativement peu parce qu'ils fonctionnent vraiment très bien. Par exemple : le freinage automatique dans les métros, même avec conducteur ; la surveillance du cœur des centrales nucléaires qui peut déclencher un arrêt d'urgence ; les commandes de vol d'un avion de ligne ; etc. En revanche certaines promesses qu'on entendait dans les années 2000, comme celle de supprimer la colonne de direction dans les voitures (le drive-by-wire par analogie avec le fly-by-wire), n'ont jamais été réalisées, sans doute car considérées comme trop risquées.

Comment la sûreté de ces systèmes automatisés est-elle assurée ? Une partie de la réponse se trouve dans les principes de conception technique, l'autre dans le cadre de développement de ces systèmes. Côté technique, c'est le règne de la redondance, du déterminisme et de la reproductibilité. Côté cadre, la sûreté des produits repose sur des cycles de développement dédiés, de la traçabilité, des audits indépendants, une attention particulière à la maintenance, une certaine lenteur du processus complet par rapport à d'autres domaines de l'informatique. Dans l'avionique civile la norme DO-178B précise les contraintes de développement des systèmes informatiques selon une classification en cinq niveaux de criticité.

On peut se demander s'il reste un humain “dans la boucle” ? Il est clair que l'humain n'est plus dans les boucles de contrôle qui sont bien trop rapides. Pour certaines boucles le cycle complet (acquisition d'une information sur l'environnement via les capteurs, calculs, production d'une commande vers l'environnement via les actionneurs) peut ne durer que quelques centaines de millisecondes, voire moins. Quand on a décidé d'automatiser les commandes de vol d'un avion de ligne, sachant que le pilote ne pourrait pas se substituer à tous les systèmes automatiques en prenant la place de l'ordinateur “dans la boucle”, la sûreté a été assurée par les choix techniques particuliers et les contraintes qui encadrent le processus de développement. Les pilotes sont formés à la cohabitation avec des systèmes automatisés, pour reprendre la main sur certaines fonctions si le système automatique se désengage, par exemple à la suite de données capteurs non fiables.

Dès qu'on relâche un peu les contraintes sur le cadre de développement, les exigences de certification et la formation des pilotes, cela peut déboucher sur des accidents du type Boeing 737MAX. Et finalement, même si le cadre contraint est respecté, il peut subsister des accidents, malgré tout. Pour certains il semblerait que les contradictions de l'automatisation, comme définies par L. Bainbridge, se soient manifestées. On peut penser au cas du vol Rio-Paris. L'émotion qu'ils suscitent est à la hauteur du degré de confiance qu'on a acquis dans ces systèmes.

Quoi qu'il en soit, personne n'a jamais suggéré d'assurer la sûreté du système automatique de commandes de vol en développant un robot-pilote installé à la place du pilote, lui-même surveillé par un humain. La sûreté du système automatisé est assurée par : des choix techniques, un cadre de développement, la formation des humains amenés à intervenir. C'est en quelque sorte une automatisation de premier ordre. Si les solutions techniques impliquent la redondance entre un système principal et un autre système qui le surveille, c'est d'une certaine manière une surveillance horizontale.

Propositions de l'agentisation : on passe à l'ordre supérieur

Quand on utilise un LLM pour produire du code, il est conseillé de relire et contrôler cette production. C'est un travail pénible, qui demande des compétences que l'être humain va justement perdre en ne pratiquant plus la production de code. Les contradictions (ironiques) de l'automatisation sont de retour. Est-ce que les promoteurs de ces “outils” envisagent d'assurer la qualité du logiciel final grâce à la redondance et à la lenteur, voire la lourdeur, des cadres de développement ?

Force est de constater que les propositions de l'agentisation ressemblent à s'y méprendre à l'idée de développer un robot-pilote installé à la place du pilote, lui-même surveillé par un humain. Quand on signale que surveiller la production de code d'une machine est pénible et risque de ne pas pouvoir assurer la qualité, la réponse est toujours orientée vers plus d'automatisation : des revues de code automatiques, des tests automatiques, un agent IA qui inspecte le travail d'un autre agent IA, etc. Tout cela surveillé par un humain, bien sûr. Lequel est de plus en plus loin de l'activité réelle qu'il pratiquait auparavant et dont il tirait les compétences qui lui sont maintenant d'autant plus indispensables qu'il doit surveiller une armée d'agents infatigables. L'humain “dans la boucle” n'est plus censé surveiller seulement un robot-pilote, mais bientôt les robots-pilotes de toute la flotte d'une compagnie. On passe à une automatisation d'ordre supérieur. Nul doute que les contradictions de l'automatisation passent elles-mêmes au niveau supérieur. Pourtant dès 2020, les auteurices de Closing the AI accountability gap: defining an end-to-end framework for internal algorithmic auditing mentionnaient l'avionique comme source d'inspiration pour une démarche d'audit de bout en bout des systèmes d'IA.

Tout ça ressemble de plus en plus à une autre ironie, celle de cette “information” due à Onion News Network : la sortie d'une nouvelle version du jeu World of Warcraft (WoW), intitulée World of World of Warcraft. Le joueur anime un personnage qui lui-même joue au jeu WoW d'origine. Les personnes interviewées sont unanimes et enthousiastes sur le réalisme du jeu ! On les entend dire : – Here I'm gonna press Alt-Shift-7 and that's gonna make my character start scrolling through the terms-of-use agreement, and user-licence agreement (ça a l'air vraiment amusant !) – I'm gonna press my up-arrow key, and that's gonna make him press his up-arrow key, which just gonna make the character on his screen move forward across the screen – When you're staring at a computer screen, you actually believe you're in a basement staring at a computer screen, with each keystroke you just think “Oh my god! It sounds exactly like keystrokes that I know from my own personal experience of hitting keys”.

Vraiment, redisons-le, toute ressemblance avec les promesses d'une certaine technologie à la mode ces temps-ci serait totalement fortuite.

#resistIAGen

@flomaraninchi@pouet.chapril.org

image

Mlle Beaumaine, Théâtre des Variétés — about 1900 — Paul Nadar (French, 1856 – 1939)

Dans les recommandations habituelles qui fleurissent depuis quelque temps pour encadrer l'usage des IA génératives, on lit systématiquement quelque chose qui ressemble à : “ne faites jamais confiance à une IAg, contrôlez soigneusement avec d'autres sources”.

Faisons un détour par les systèmes critiques avant d'examiner les moyens de suivre ces recommandations. Nous ne traiterons pas ici de la question mais alors, pourquoi utiliser l'IAg ?, qui mériterait en soi un long développement.

Systèmes critiques : redondance de capteurs, identification des sources, probabilités de défaillance

Dans les systèmes embarqués critiques on assure la sûreté par de la redondance, en particulier la redondance matérielle des dispositifs qui permettent d'acquérir des informations sur l'environnement physique. Par exemple, si une fonction critique utilise les données d'un capteur (l'altitude ou la vitesse d'un avion, la température d'un processus chimique en cours, l'état d'un réacteur nucléaire...), il est de bon goût de prévoir au moins 2 capteurs (pas forcément du même modèle), au cas où l'un d'eux serait en panne. Un problème est détecté dès que les deux capteurs diffèrent suffisamment pendant suffisamment longtemps. Pour pouvoir déterminer quel capteur est en panne, on en met même plutôt 3, pour pouvoir voter, en faisant l'hypothèse que si deux capteurs donnent des valeurs cohérentes entre elles, mais différentes de la valeur du troisième, la probabilité est forte que le troisième soit défaillant. Parfois on met même 4 capteurs. Quoiqu'il en soit, la sûreté repose sur des sources d'informations redondantes, avec possibilité d'identifier la provenance des informations (capteur 1, capteur 2, ...) pour comparer. Par ailleurs la sûreté déclarée des systèmes qui utilisent ces capteurs repose sur une analyse des défaillances possibles. La probabilité qu'un capteur tombe en panne est trop grande pour qu'on fasse dépendre la sûreté de tout le système de cette unique source d'information. La probabilité de deux pannes simultanées est déjà plus faible, pour 4 pannes simultanées on considère que la probabilité est tombée suffisamment bas pour que le risque (qui n'est jamais nul) soit tolérable.

Comment contrôler la production des IA génératives ?

Cette analogie permet-elle de comprendre comment appliquer la recommandation “ne faites jamais confiance à une IA, contrôlez soigneusement avec d'autres sources” ? Imaginons une situation où la production de l'IAg va servir dans un processus de décision important, par exemple. Comment contrôler ? Sommes-nous vraiment dans la situation de la redondance de sources d'information, avec identification de la provenance et estimation des probabilités de défaillances simultanées ?

Si on fait une photo de l'état actuel de l'information en ligne — ou peut-être qu'il aurait fallu faire cela il y a 3 ans — on peut encore se convaincre que les productions des IA génératives peuvent être confrontées à ce qu'on trouve dans un espace informationnel non pollué, et que l'identification de provenance est encore possible.

Mais les productions des IA génératives et les informations authentiques cohabitent dans un même espace. Avec cet effet de pollution informationnelle à grande échelle engendré par un usage répandu et inconsidéré des IA génératives elles-mêmes, comment la situation évolue-t-elle ? va-t-on pouvoir encore distinguer l'authentique du généré, pour continuer à “contrôler” les productions des IAg ? Tout porte à croire que la redondance et la connaissance des sources, indispensables à la garantie de qualité de l'information sur laquelle on se base pour la suite du travail, sont menacées.

Comment contrôler ce que dit une IA générative sur un sujet, si les moteurs de recherche fournissent également des résumés faits par des IAg, qui plus est de sources elles-mêmes générées par IA ? On s'inquiète parfois de dégradation intrinsèque de la qualité due au fait que les IAg se nourrissent des productions d'autres IAg. Mais le risque principal pour l'utilisateur est de ne plus pouvoir distinguer les sources, et d'être donc dans l'incapacité d'appliquer la fameuse injonction de contrôler les productions des IAg.

#resistIAGen

@flomaraninchi@pouet.chapril.org

Il y a un an j'écrivais ça.

Depuis j'ai eu de multiples occasions d'argumenter contre des gens qui trouvent toujours un usage à ces objets.

Parler d'impacts environnementaux ?

Depuis quelque temps je me dis que les arguments sur les impacts environnementaux des IAg ne marchent pas. On nous répond souvent que c'est tout le numérique qui a des impacts environnementaux désastreux (sous-entendu : on n'est plus à ça près).

A quoi je réponds : raison de plus pour ne pas en remettre une couche alors que justement il s'agirait de réduire le numérique.

Ou alors on entend que ce n'est pas grand chose par rapport à l'aviation, l'industrie, l'agriculture, … ou autre secteur.

Argument classique, encore une fois il faut réduire de partout ; et de plus le numérique est un accélérateur de tout le reste. D'ailleurs c'est vendu comme ça. Les IAg vont paraît-il booster la productivité et donc la croissance.

On entend aussi qu'une requête ChatGPT ça ne coûte vraiment “rien” (en électricité, en eau, en CO2 ...).

Oui, c'est vrai, un mail non plus. Mais il faut regarder l'infrastructure dessous. Et il y doit bien y avoir une raison à la frénésie de construction de datacenters et au rallumage de vieilles centrales nucléaires. Et aux gains de Nvidia.

On ne peut pas se permettre l'aggravation des impacts envt du numérique due aux IAg. Point.

Les bigtech qui imposent un narratif sur le calcul des coûts à la requête, c'est un peu comme si l'industrie du tabac avait dit que tirer une bouffée d'une cigarette n'augmente le risque de maladie que de 0.00001% pour les enfants, bien moins que la junk food ou le patin à roulettes.

Parler du micro-travail abrutissant derrière l'IA

Après avoir mis les arguments sur les impacts environnementaux un peu de côté, j'ai cru un moment que le travail humain d'annotation caché derrière ces prétendues intelligences artificielles était susceptible de frapper les esprits. Mais il semblerait que non.

Savoir que des gens se sont farci des heures de contenus les plus pourris du web (au point d'être atteints de TSPT) pour entraîner un garde-fou et qu'on puisse demander à ChatGPT un résumé ou une recette de nouilles au fromage sans être soi-même confronté à ces horreurs, visiblement ça ne suffit pas à détourner du bidule. (oui, je sais, le smartphone, les mines, etc. Encore une fois : justement, arrêtons au moins d'en rajouter).

Montrer que ça ne marche même pas (ou même que ça ne peut pas marcher)

Ensuite je me suis dit : à force de parler des impacts désastreux, on en oublie de dire que ça ne marche même pas. Que fondamentalement ça ne peut pas faire ce pour quoi c'est vendu.

Les délires autour du vibe-coding ou des agents montrent que la croyance dans les capacités d'autonomie du numérique est très ancrée dans l'imaginaire. Même chez les informaticiens qui devraient quand même savoir que ces capacités sont totalement illusoires et que le numérique ça se surveille comme le lait sur le feu.

Ça rejoint un autre billet : L'imaginaire d'une infrastructure numérique auto-entretenue immuable.

Le but des IAg est ce qu'elles font

Et puis j'en suis venue à me dire que la qualité des résultats n'est pas la question centrale, qu'en fait ça marche parfaitement bien pour les gens qui les fabriquent ou les promeuvent.

J'ai lu ce matin Deflating “Hype” Won’t Save Us et c'est une argumentation impeccable de cet aspect.

Pour résumer (mais lisez tout) : “The purpose of a system is what it does” + “this is not a bug, this is a feature”.

Des alternatives éthiques/sobres/ouvertes/... ??

Reste la question de la possibilité d'existence de variantes sobres, éthiques, souveraines, ouvertes, nourries à la bonne herbe de nos prés bien français, avec autorisation des propriétaires.

Mais soyons sérieux : – Où sont les petites mains derrière les produits des IAg “éthiques” – Par quel miracle serait-il rentable de vendre une IAg sans avoir pillé la terre entière pour la construire, alors qu'OpenAI n'est toujours pas rentable ? – Pourquoi donc dans les mêmes conditions sociales et économiques ces IAg éthiques seraient-elles bonnes pour les travailleurs, alors que les autres sont un désastre ? – Pourquoi ne contribueraient-elles pas aux phénomènes de pollution informationnelle galopante déjà installés ?

Pour un usage frugal et responsable des IA génératives, vraiment ?.

Et à la fin on a droit à la tyrannie du retard, à la croyance en un mouvement autonome du “progrès” auquel il faut s'adapter…

#resistIAGen

@flomaraninchi@pouet.chapril.org

image

Walker Evans (American, 1903 – 1975), photographer — Roadside Sandwich Shop. Ponchatoula, Louisiana, 1936

Hier j'ai lu le IA génératives : le contre et le pour. Ça vaut vraiment le coup de lire cet article de Julien Falgas avant ou après pour y repérer les clichés : Comment le discours médiatique sur l’IA empêche d’envisager d’autres possibles.

Dans l'article du Blog Binaire on trouve bien sûr le désormais traditionnel argument d'inévitabilité, ici sous la forme : “Ne nous faisons pas trop d’illusions : le train est lancé et, du fait de la compétition internationale, il ne semble pas qu’on puisse l’arrêter. Mais on pourrait au moins le ralentir et en focaliser les usages sur les usages positifs.”.

Mais c'est un autre argument qui mérite qu'on y revienne : l'usage positif au service d'une prétendue démocratisation de l'expression écrite. On la trouve ici sous la forme :

“il faut rappeler que de nombreuses personnes n’arrivent pas à exprimer leurs idées, leurs sentiments, leur colère … parce qu’elles ne maîtrisent pas suffisamment la langue. Les IA génératives leur redonnent la parole. L’utilisation de ces outils pour quelqu’un d’instruit est de l’économie d’effort, voire de la paresse. Pour ceux qui n’ont pas eu la grande chance de longues études, c’est une libération.”

Que dire ? Le rappel est utile, et je suis bien d'accord. Mais qu'on puisse affirmer “Les IA génératives leur redonnent la parole”, ça me sidère.

Si l'usage de ChatGPT avait effectivement des effets de nivellement par le haut de l'usage de la langue, j'en serais vraiment ravie (en oubliant momentanément les impacts socio-environnementaux et les patrons des BigTech politiquement infréquentables).

Mais c'est une fausse promesse.

Je ne crois pas cinq minutes à cette fameuse démocratisation de la créativité, qui permettrait à des personnes peu à l'aise avec l'écriture d'en maîtriser complètement les effets grâce aux IAg. Imbriquer sa pensée et l'écriture, c'est compliqué. Maîtriser suffisamment l'écriture pour que ce soit un outil au service de la pensée et pas un obstacle en soi, c'est compliqué.

Mais on n'apprend pas à faire la cuisine en promptant son sandwich chez Subway.

Le faire croire est détestable. Quand je vois quelqu'un qui ne sait pas écrire suffisamment bien pour transmettre ce qu'il pense, précisément, profondément, j'ai envie d'essayer de le lui apprendre, pas de lui donner ChatGPT, ce qui selon moi est un excellent moyen d'assurer qu'il ne saura plus jamais comment exprimer fidèlement ce qu'il pense.

Autres arguments

A la suite du thread sur mastodon que j'ai repris ci-dessus, il y a eu plusieurs remarques qui apportent des arguments complémentaires, et des hasards de pouet-line qui résonnent très fort avec certains aspects des remarques ci-dessus.

Illettrisme

Grâce à Vincent-Xavier j'ai lu La dignité retrouvée des mots : plongée dans la France de l'illettrisme juste après avoir commenté l'article du Blog Binaire. Le paragraphe suivant m'a paru particulièrement bienvenu pour revenir sur terre face aux promesses technosolutionnistes :

“Dans une société de plus en plus numérisée, dématérialisée, automatisée, l’illettrisme devient une prison. Sans guichet. Sans humain. Souvent sans traduction possible”

L'idée que ChatGPT puisse apporter une solution à cet état de fait serait risible si ce n'était pas si triste.

Dépendance à l'outil

Corse_pia fait remarquer que l'usage de ChatGPT pour “rendre la parole” à quelqu'un qui ne maîtrise pas l'écrit supposerait que cette personne ait les moyens matériels et financiers d'accéder à ChatGPT, qui “serait toujours là quand il y en a besoin” et toujours “gratuit”. Bref, une erreur sur ce qu'est l'éducation et une discrimination sur toute la ligne.

Effectivement, même si ça marchait très bien pour “rendre la parole”, on installerait une telle dépendance, y compris financière, que ça vaudrait le coup de se demander s'il n'y a pas une autre solution (remettre des moyens dans l'éducation nationale, par exemple).

#resistIAGen

@flomaraninchi@pouet.chapril.org

Je crois qu'il serait intéressant de faire une lecture comparée de ce genre de guide et du manifeste d'objection de conscience :

Dans le guide, il est “amusant” de noter quelques petites choses, par ci par là. Par ex au paragraphe 1.1/ Recherche d’informations (cas général) on voit : “Mistral AI société FR, hébergement US”.

Mais ce qui me laisse pantoise, c'est l'affirmation absolument gratuite, sans aucune source qui permette de l'appuyer (page 12) :

“Les assistants IAG sont capables de rechercher et synthétiser des informations, à partir de requêtes formulées en langage naturel, sans que l’utilisateur ait besoin de maîtriserle vocabulaire du domaine. (...) ces outils innovants peuvent générer des réponses synthétiques et personnalisées, plutôt que de simples listes de liens. “

Pour un usage en recherche.

Depuis quand est-il normal de ne pas maîtriser le vocabulaire de son domaine de recherche ? Et si c'est pour des gens hors domaine, comment vont-ils ensuite pouvoir appliquer la recommandation de la même page :“il est indispensable de croiser les sources et vérifier les informations obtenues” ?

Où est la source qui permet d'affirmer de manière aussi péremptoire qu'une machine à faire des phrases permet de “synthétiser des informations” ?

A quel moment est-il devenu acceptable de déléguer à cette même machine à faire des phrases le travail d'examen minutieux des “simples listes de liens”, pour s'approprier à la fois leur contenu et le graphe de connexion entre les sources, qui donne une idée des frontières raisonnables d'un domaine ?

En quoi une réponse “personnalisée” a-t-elle un intérêt en recherche ? Et qu'est-ce que ça veut dire, d'ailleurs ? On n'est pas en train de choisir un carrelage pour la cuisine, là.

L'accumulation des messages de mise en garde (p 6) :

“Notez bien que l’utilisateur est seul responsable devant la loi des contenus qu’il produit à l’aide de l’IAG et du respect de la réglementation relative à ses usages.”

suivi de :

“Qualité et pertinence des résultats : les résultats générés dépendent de la performance de l’IAG et de ses données d’entrée (quantité, qualité, fraicheur, etc.). Des résultats biaisés, incomplets ou même erronés peuvent être obtenus.”

laisse perplexe.

Je crois que c'est la 1ère fois qu'on nous fait à répétition une telle pub pour des outils intrinsèquement non fiables, en nous rappelant en permanence que si une erreur en découle ce sera notre faute.

Et en faisant semblant de croire qu'un usage responsable et conscient des enjeux va permettre d'infléchir l'exponentielle des impacts environnementaux du numérique. Voir aussi Pour un usage frugal et responsable des IA génératives.

N'importe qui d'un peu conscient des enjeux et effectivement responsable ne voit qu'une solution : ne surtout pas mettre le doigt dans cet engrenage.

Un jour on complétera le manifeste d'objection de conscience par un argumentaire sur le non-sens total des arguments publicitaires dans l'#ESR et l'EN (et à plein d'autres endroits aussi).

#resistIAGen

@flomaraninchi@pouet.chapril.org

image

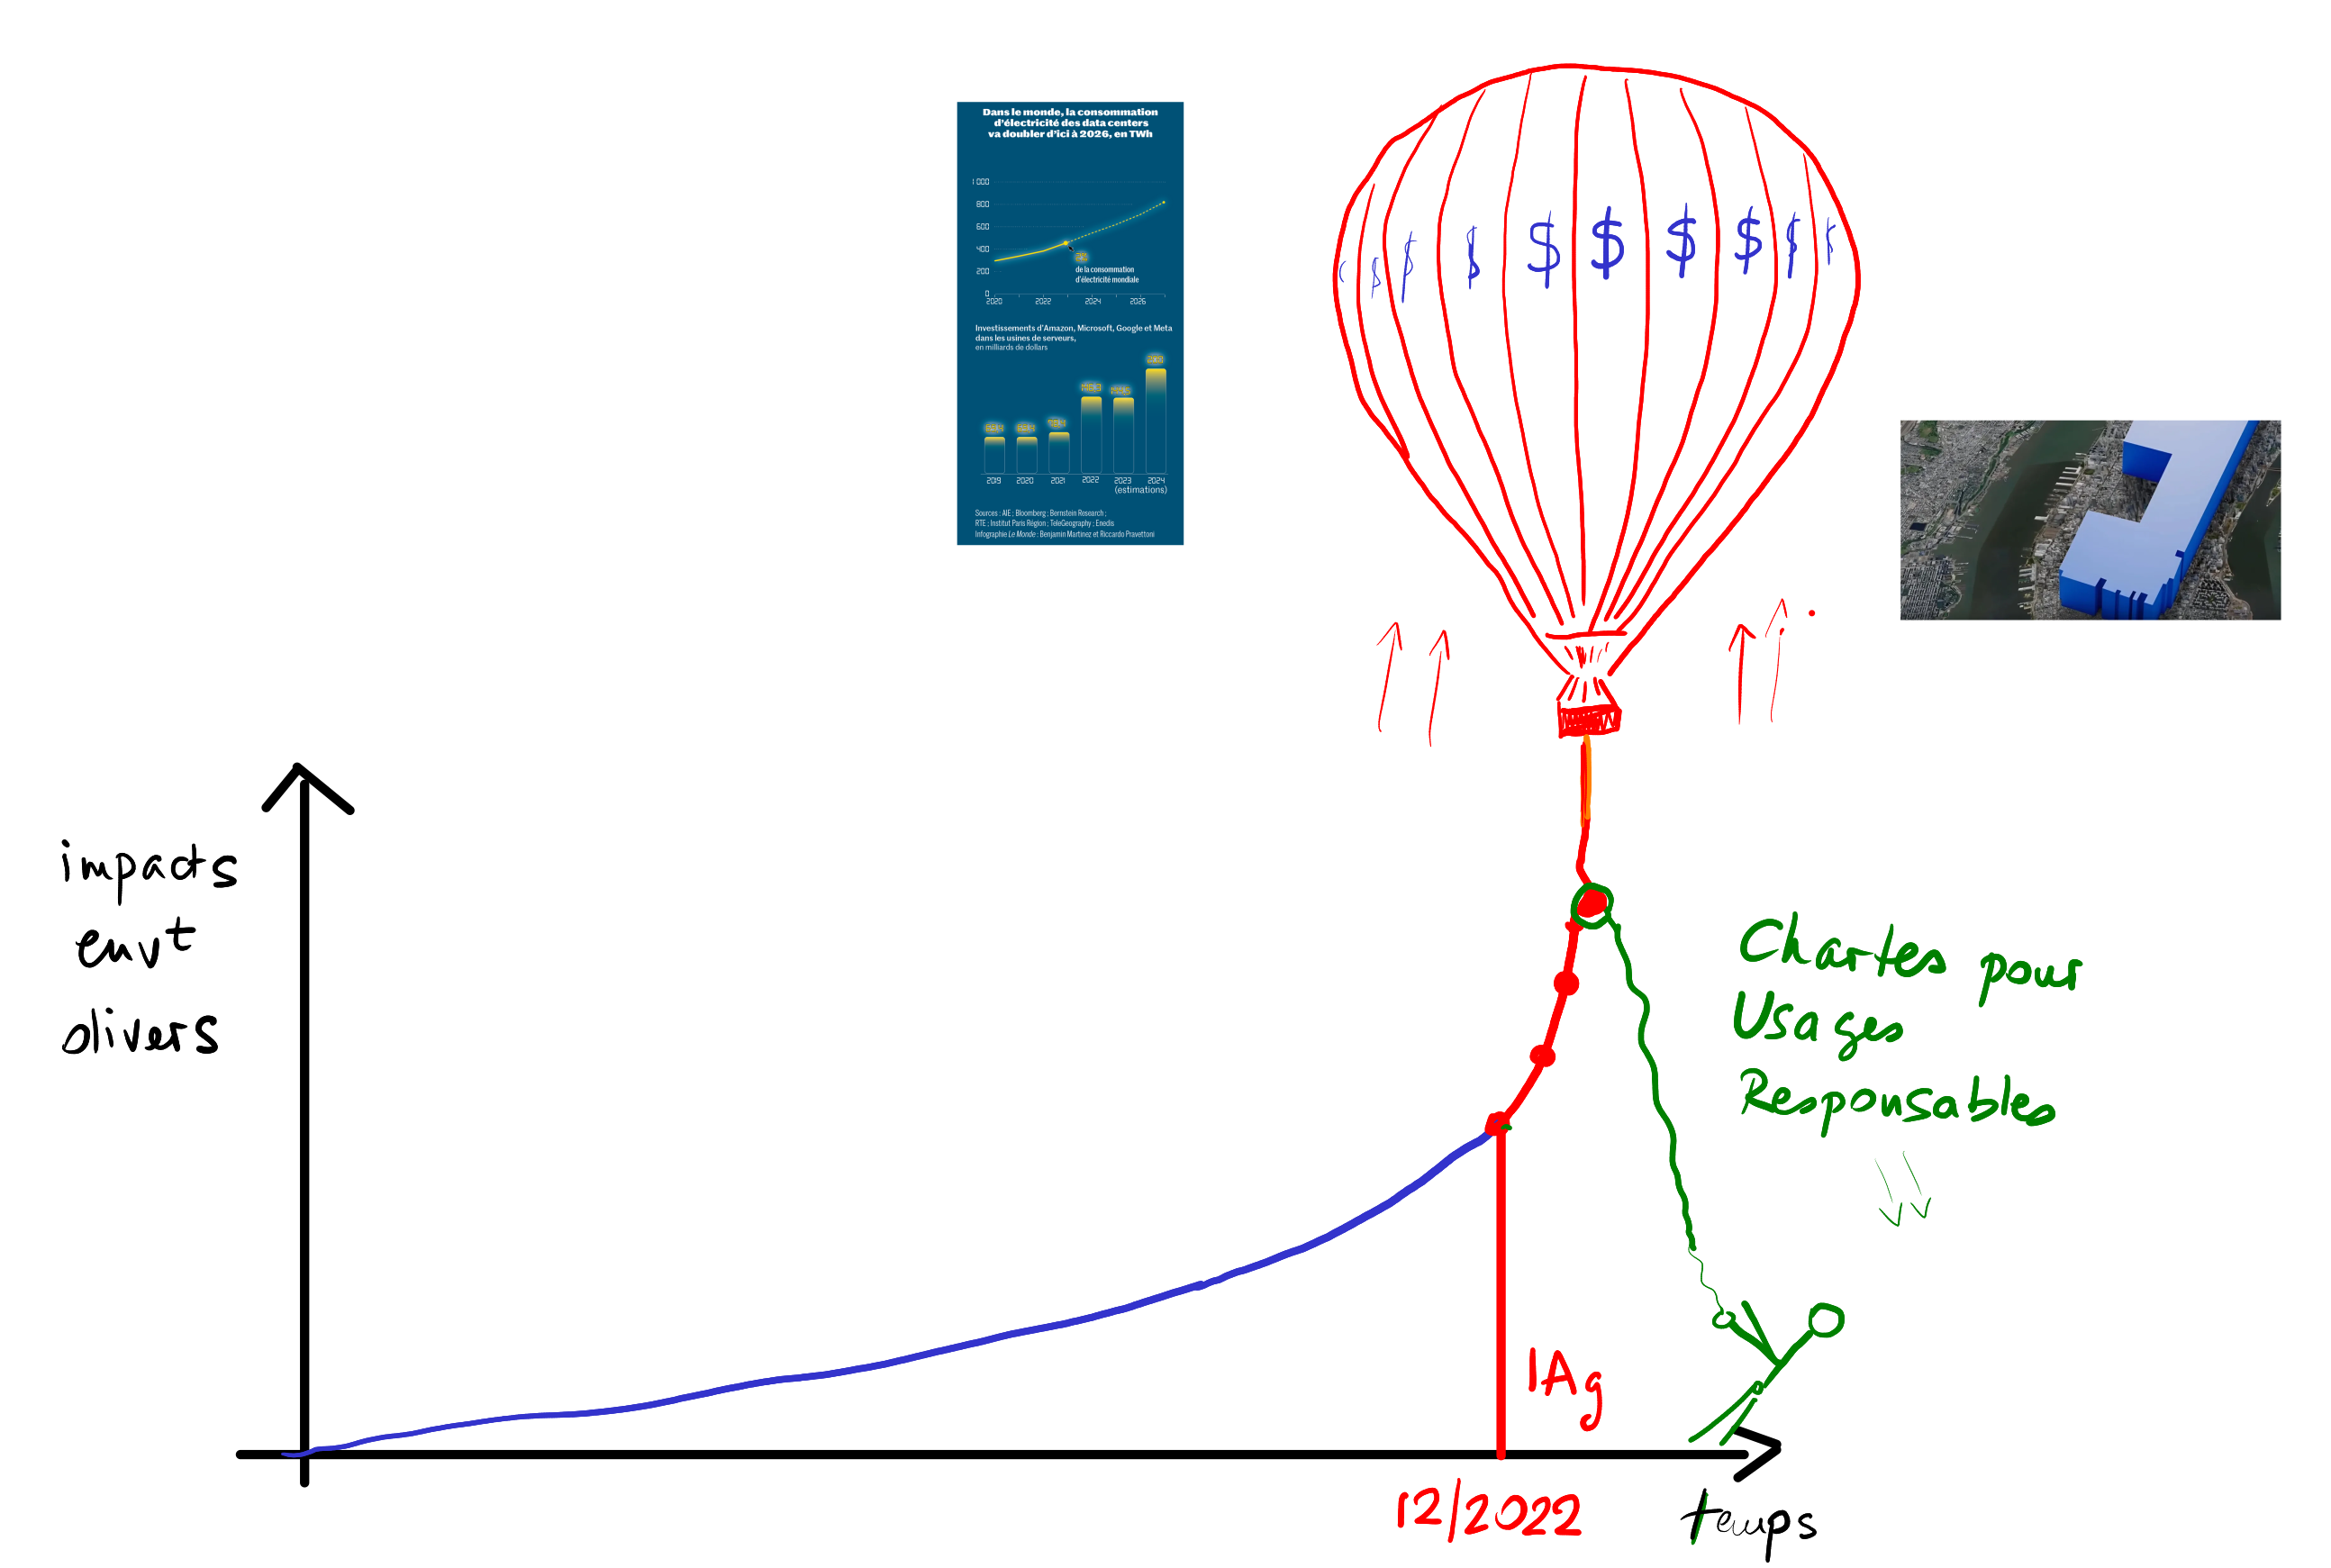
Les impacts environnementaux du numérique au court du temps

ALT: un diagramme des impacts environnementaux divers du numérique (ordonnée) en fonction du temps (abscisse). La courbe monte régulièrement. En 2022 elle se redresse brutalement à l'arrivée des IA génératives. Une montgolfière rouge décorée de $ y est accrochée et la tire vers le haut. A côté on voit une courbe de croissance de la demande en électricité, avec la légende “Dans le monde, la consommation d'électricité des datacenters va doubler d'ici 2026, en TWh” (note : elle doublerait aussi même si elle était exprimée dans une autre unité :–)). Sur la droite en haut on voit une image d'énorme datacenter bleu comme posé sur Manhattan, pour donner l'échelle. Cette image vient d'une communication officielle de META sur les réseaux sociaux. Sur la droite tout en bas on voit un petit bonhomme tout frêle, dessiné en vert, arc-bouté pour tenir une corde accrochée quelque part en haut de la courbe des impacts redressée, un peu en dessous de son point d'accroche à la Mongolfière. La courbe a l'air très légèrement déformée par cette traction vers le bas. Mais vraiment très légèrement. A droite de l'image, en vert aussi, on lit : Chartes pour usages responsables.

Il manque encore à cette image l'idée que le développement tous azimuts de chartes d'usages responsables, éthiques, sobres, raisonnables, etc., contribue aux courants d'air qui font monter la montgolfière.

#resistIAGen

(Image évidemment faite à la main avec minutie – ou presque – par un être humain certifié authentique).

@flomaraninchi@pouet.chapril.org